Membaca Kurva Learning: Tanda Model Underfitting atau Overfitting
Kamu sudah melatih model, skor akurasi di data latih terlihat bagus, tapi hasilnya jeblok saat diuji ke data baru. Sebelum menambah data atau mengganti algoritma, ada satu grafik yang bisa menjawab penyebabnya: kurva learning. Grafik ini memetakan skor training dan validation terhadap jumlah sampel latih, sehingga kamu bisa melihat apakah model masih kekurangan informasi atau sudah terlalu menyesuaikan diri dengan data latih.
Tulisan ini membahas cara membaca kurva learning, pola yang perlu dikenali, dan tindakan praktis untuk masing-masing pola. Semua contoh memakai scikit-learn karena fungsinya sudah tersedia langsung tanpa perlu menulis kode plotting manual.
Apa yang Ditunjukkan Kurva Learning
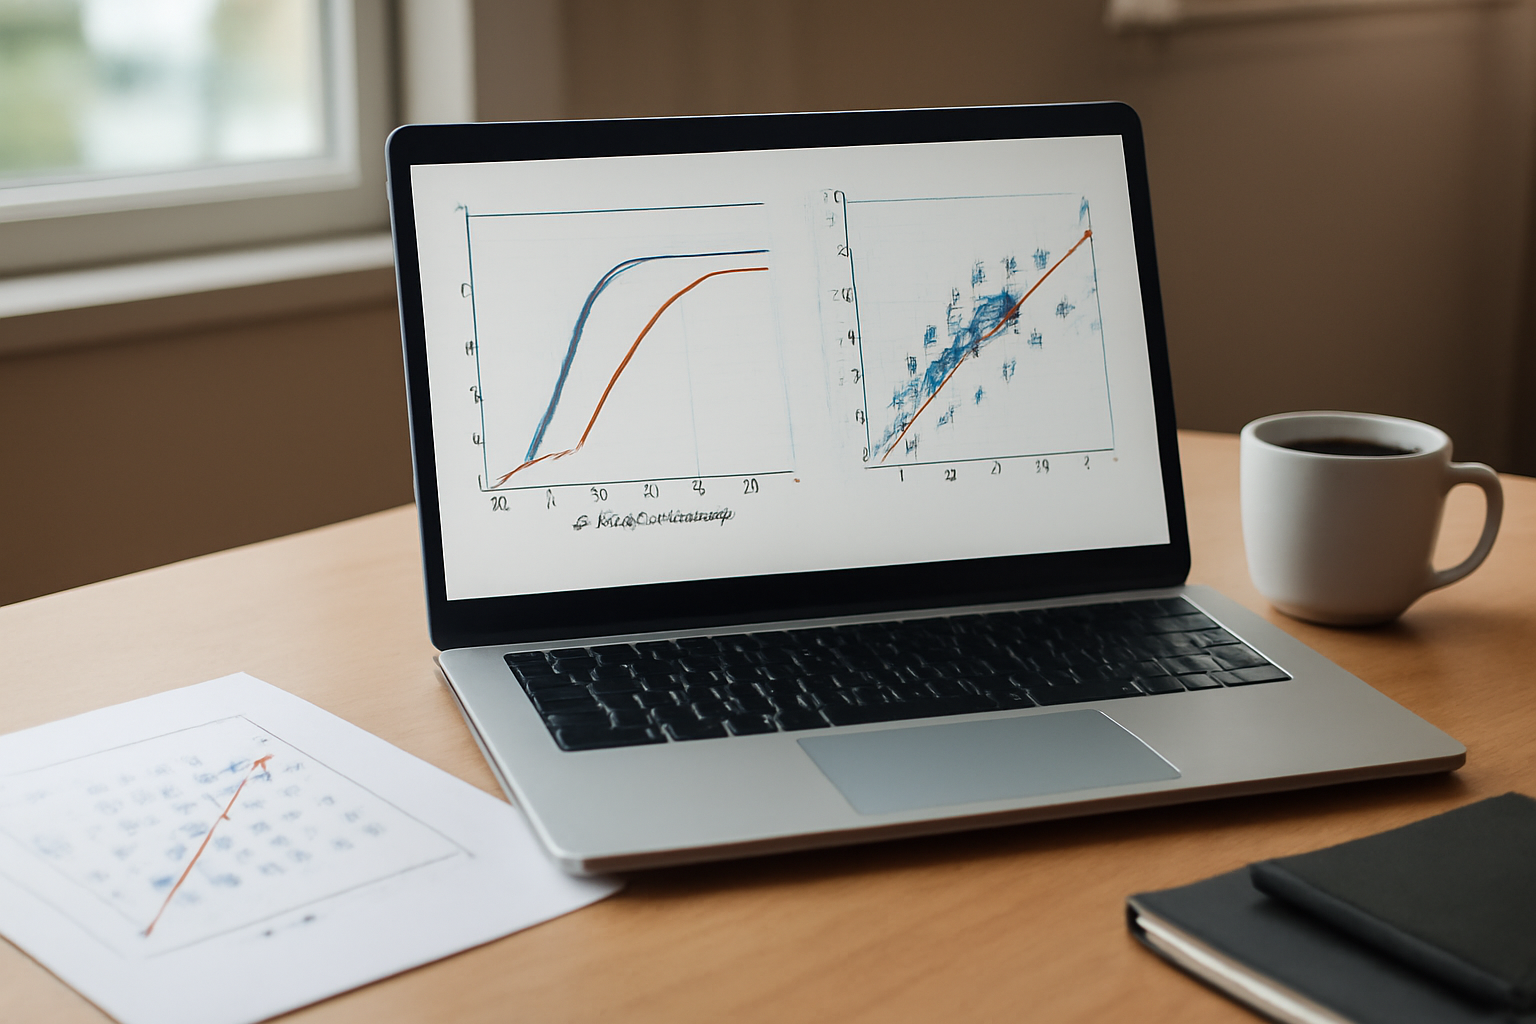
Kurva learning menggambar dua garis pada satu bidang: skor pada data latih dan skor pada data validasi, keduanya sebagai fungsi dari ukuran subset data latih. Sumbu horizontal berisi jumlah sampel yang dipakai untuk melatih model, sumbu vertikal berisi skor evaluasi seperti akurasi atau F1.
Perbedaan antara kedua garis menunjukkan seberapa besar jarak antara performa di data yang dilihat model dan data yang belum pernah dilihat. Jarak lebar berarti model belum bisa menggeneralisasi. Jarak sempit dengan skor rendah di kedua garis berarti model bahkan belum mampu menangkap pola di data latih.
Fungsi learning_curve di scikit-learn melakukan ini secara otomatis. Ia membagi data menjadi beberapa fold, melatih model pada porsi data latih yang bertambah, lalu mengevaluasi pada sisa data di setiap fold. Hasilnya berupa rata-rata skor beserta rentang variasinya.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.model_selection import learning_curve
from sklearn.tree import DecisionTreeClassifier

model = DecisionTreeClassifier(random_state=42)

sizes, train_scores, val_scores = learning_curve(
    model, X, y,
    train_sizes=np.linspace(0.1, 1.0, 10),
    cv=5,
    scoring="f1",
    n_jobs=-1,
)

train_mean = train_scores.mean(axis=1)
val_mean = val_scores.mean(axis=1)

plt.plot(sizes, train_mean, marker="o", label="Training")
plt.plot(sizes, val_mean, marker="s", label="Validation")
plt.xlabel("Jumlah sampel latih")
plt.ylabel("F1 score")
plt.legend()
plt.show()
Perhatikan bahwa scoring menentukan jenis skor yang diplot. Untuk klasifikasi tidak seimbang, jangan pakai akurasi karena angkanya bisa menipu. Pilih F1, recall, atau metrik lain yang sesuai dengan tujuan model.
Pola Overfitting: Skor Latih Tinggi, Validasi Tertinggal
Overfitting muncul sebagai dua garis yang berjauhan. Skor training mendekati sempurna, sementara skor validasi jauh di bawahnya dan cenderung mendatar. Model menghafal detail data latih, termasuk noise yang tidak akan ditemui saat prediksi sesungguhnya.
Pola ini biasa terjadi pada model berkapasitas besar seperti decision tree tanpa batas kedalaman, k-nearest neighbors dengan nilai k kecil, atau jaringan saraf dengan terlalu banyak parameter. Semakin banyak sampel latih ditambahkan, skor training perlahan turun karena model sulit menghafal semuanya, tetapi skor validasi biasanya tetap tertinggal jauh.
Langkah perbaikan yang paling sering berhasil:
- Kurangi kompleksitas model, misalnya batasi
max_depthpada decision tree atau tambahkan regularisasi L2. - Kurangi jumlah fitur dengan seleksi fitur, karena fitur yang tidak relevan memperbesar peluang model menghafal kebetulan.
- Tambahkan data latih bila memungkinkan. Overfitting yang murni akibat data sedikit akan membaik ketika sampel bertambah.
- Pakai cross-validation yang lebih rapat agar estimasi performa tidak bias.
Jika data latihmu punya outlier ekstrem, model bisa ikut menghafalnya. Bersihkan dulu lewat cara menangani outlier sebelum melatih model ML, lalu plot ulang kurvanya untuk melihat apakah jarak kedua garis menyempit.
Pola Underfitting: Kedua Garis Rendah dan Berdekatan
Underfitting tampak sebagai dua garis yang rapat tapi berada di bawah. Baik skor training maupun validasi sama-sama rendah. Model terlalu sederhana untuk menangkap pola yang ada, mirip menggambar garis lurus pada data yang melengkung.
Menambah data latih tidak akan banyak membantu di pola ini. Kurva training dan validasi akan bertemu di level skor yang sama, tanda bahwa keterbatasan ada pada kapasitas model atau pada fitur yang dipakai.
Yang perlu dilakukan:
- Tingkatkan kapasitas model, misalnya tambah kedalaman tree, naikkan nilai k pada kNN, atau pakai model berbasis ensemble.
- Rekayasa fitur. Fitur yang lemah membuat model apa pun kesulitan menemukan pola. Interaksi antarfitur atau transformasi logaritmik sering membuka jalan.
- Periksa kembali proses pembersihan data. Kolom yang salah tipe atau nilai yang terlanjur dinormalisasi ganda bisa menghapus sinyal penting.
- Pastikan metrik yang dipakai memang sesuai. Skor rendah pada metrik yang salah bukan berarti model buruk.
Pola Sehat: Dua Garis Bertemu di Skor Tinggi
Model yang baik menunjukkan kurva training dan validasi yang saling mendekat seiring bertambahnya sampel, dengan skor akhir yang tinggi dan selisih kecil. Selisih kecil di awal adalah hal normal karena model dengan sedikit sampel mudah menghafal.
Yang penting diperhatikan adalah arah kurva pada ujung kanan. Jika garis validasi masih naik ketika data latih ditambah, menambah data kemungkinan besar masih memberi perbaikan. Jika garis validasi sudah mendatar sementara garis training juga stabil, kamu sudah mendekati batas kemampuan model dengan fitur yang ada.
Untuk model yang akan dipakai di produksi, jalankan cross-validation dengan jumlah fold memadai agar kesimpulan dari kurva learning tidak bergantung pada satu pembagian data kebetulan.
Membandingkan Dua Model Lewat Kurva
Kurva learning juga berguna saat harus memilih antara dua algoritma. Plot keduanya pada satu gambar, lalu bandingkan dua hal: level skor validasi dan lebar jarak antar garis.
Model A mungkin punya skor validasi lebih tinggi tetapi jaraknya lebar, tanda masih overfitting. Model B punya skor sedikit lebih rendah tapi stabil. Untuk data yang terus bertambah, model B sering jadi pilihan lebih aman karena tidak perlu penyetelan ulang setiap kali distribusi data bergeser.
Jangan memilih berdasarkan satu titik saja. Lihat tren di seluruh rentang ukuran sampel, dan utamakan model yang kurvanya belum menunjukkan tanda penurunan tajam.
Kesalahan Umum Saat Membaca Kurva
Beberapa hal sering membuat kesimpulan dari kurva learning jadi keliru.
Pertama, memakai data uji di dalam proses learning_curve. Fungsi ini sudah membagi data latih menjadi fold internal, jadi data uji tidak boleh ikut dimasukkan. Kalau ikut, kurva akan terlalu optimistis dan tidak mencerminkan performa sebenarnya.
Kedua, mengabaikan pita variasi. Sebagian implementasi menampilkan rentang skor antar fold, bukan hanya rata-rata. Pita yang lebar menandakan hasil sangat bergantung pada pembagian data, biasanya karena dataset kecil atau ada kelas yang tidak terwakili merata di setiap fold.
Ketiga, menyimpulkan hanya dari satu metrik. Model dengan akurasi mirip bisa punya perilaku berbeda pada kelas minoritas. Cek juga metrik lain lewat confusion matrix sebelum memutuskan perbaikan.
Keempat, lupa bahwa kurva learning bukan alat penyetelan hyperparameter. Ia menunjukkan gejala, bukan solusi. Setelah gejalanya jelas, gunakan grid search atau random search untuk mencari kombinasi parameter yang tepat, lalu plot ulang kurva untuk memverifikasi.
Kalau model sudah stabil dan siap dipakai, langkah berikutnya adalah menyimpannya agar bisa dipakai ulang tanpa melatih dari awal. Simpan lewat cara menyimpan model machine learning ke file dengan joblib. Untuk kebutuhan menampilkan hasil prediksi ke pengguna, kamu bisa mengikuti panduan membuat aplikasi prediksi sederhana dengan Streamlit. Jika aplikasimu butuh memuat data dari server tanpa reload halaman, lihat juga perbandingan plugin pengiriman data asinkron di perbandingan 3 plugin jQuery untuk load data tanpa refresh. Untuk proyek yang menyentuh perangkat keras dan penyimpanan data di sisi klien, ada baiknya membaca tips firmware untuk pemula: pilih bahasa, debug, dan simpan data.
Ringkasan
Kurva learning memetakan skor training dan validation terhadap jumlah sampel latih. Jarak lebar dengan skor training tinggi berarti overfitting, sedangkan kedua garis rendah dan rapat berarti underfitting. Dua garis yang bertemu di skor tinggi menandakan model sudah seimbang. Baca arah kurva di ujung kanan untuk memutuskan apakah menambah data masih berguna, dan bandingkan beberapa model lewat bentuk kurvanya, bukan hanya satu angka skor.
Pertanyaan yang Sering Diajukan
Berapa jumlah sampel minimum agar kurva learning informatif?
Tidak ada ambang pasti, tetapi kurva baru terlihat polanya ketika setiap fold punya cukup sampel di tiap kelas. Untuk klasifikasi dengan kelas minoritas kecil, pakai stratified fold dan mulai dari ukuran sampel yang memastikan kelas minoritas tetap terwakili.
Apakah kurva learning bisa dipakai untuk masalah regresi?
Bisa. Ganti parameter scoring ke metrik regresi seperti neg_mean_squared_error atau r2. Perhatikan bahwa scikit-learn memakai konvensi negatif untuk metrik error, jadi skor yang lebih tinggi selalu berarti lebih baik.
Kalau garis validasi masih naik, apakah cukup menambah data?
Menambah data biasanya membantu, tapi cek juga apakah ada fitur yang belum dimanfaatkan. Terkadang kenaikan skor validasi datang dari perbaikan fitur, bukan dari penambahan baris data. Uji keduanya secara terpisah agar tahu mana yang memberi dampak lebih besar.